L’IA ne se joue plus uniquement dans les hyperscalers. Une nouvelle génération de processeurs – NPU, TPU, MPU, MCU, FPGA et autres accélérateurs spécialisés – redistribue le calcul entre data center, serveur d’entreprise, poste de travail et objet connecté. Mais derrière la promesse d’une IA partout, la question reste ouverte : ces puces sont-elles une révolution pour les entreprises, ou une fragmentation coûteuse de l’infrastructure ?
Une prolifération d’acronymes, pour une logique unique
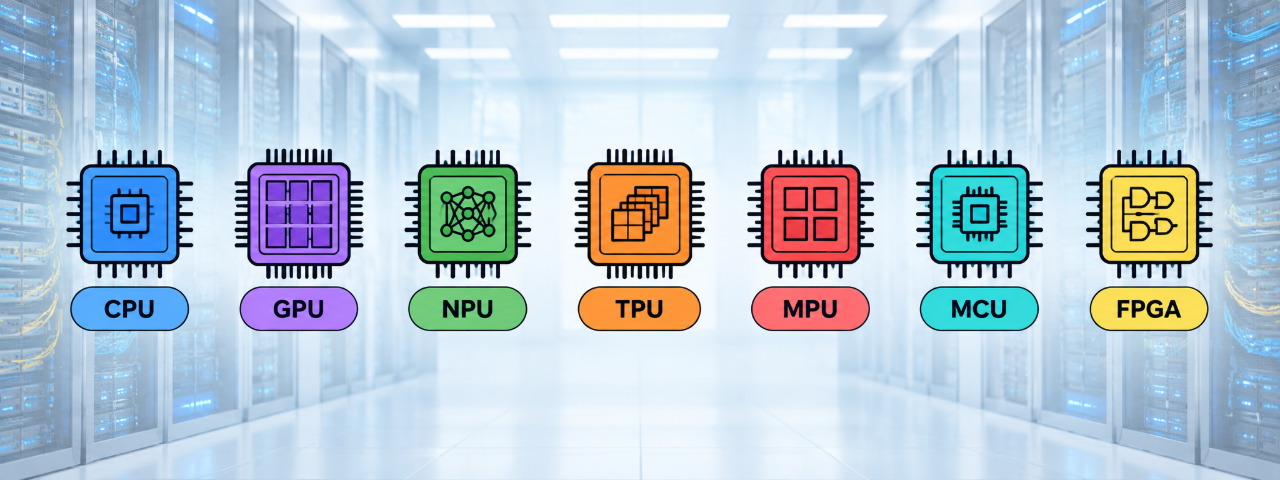
Le vocabulaire s’est considérablement complexifié. Le CPU reste le chef d’orchestre généraliste ; le GPU domine l’entraînement et l’inférence à grande échelle ; le NPU accélère les réseaux de neurones, surtout en local ; le TPU désigne les circuits massivement parallèles optimisés pour les tenseurs, notamment chez Google ; le FPGA offre une logique reconfigurable ; les MCU et MPU structurent, eux, l’informatique embarquée et l’edge.
Cette diversification répond à une contrainte simple : l’IA n’a pas les mêmes exigences selon qu’elle entraîne un modèle de fondation, exécute un agent dans un data center, analyse une vidéo industrielle ou déclenche une action sur une machine-outil. Les NPU sont conçus pour l’inférence à la périphérie, avec une faible consommation et un traitement local en temps réel, sans dépendre systématiquement du cloud.
Les architectures modernes ne s’opposent plus : elles se superposent. Un PC professionnel peut associer CPU, GPU et NPU ; un système industriel peut répartir capteurs, contrôle moteur et inférence entre plusieurs MCU, MPU et NPU. STMicroelectronics décrit ainsi une approche distribuée plutôt qu’un processeur unique censé tout absorber.
Le vrai enjeu : l’IA devient une question d’infrastructure
Pour les directions IT, le choix du processeur n’est plus un détail d’architecture, il conditionne la latence, la souveraineté des données, la facture énergétique et la capacité à industrialiser l’IA.
- Le premier levier est la latence. Une IA embarquée dans une caméra, un véhicule, un robot ou un équipement de production ne peut pas se permettre un aller-retour vers un data center distant. Le NPU permet de traiter localement des tâches répétitives – vision, détection, reconnaissance vocale, maintenance prédictive – avec des réponses quasi immédiates.
- Le deuxième est l’énergie. Les GPU restent incontournables pour l’entraînement et les charges massives, mais leur puissance électrique devient un goulot d’étranglement. Les accélérateurs spécialisés visent précisément à réduire le coût énergétique par inférence, en particulier pour les déploiements permanents en périphérie. Les NPU sont présentés comme des composants optimisés pour un traitement continu à faible consommation sur caméras, équipements industriels et objets IoT.
- Le troisième est la donnée. Traiter localement des informations sensibles – images de sites industriels, dossiers médicaux, flux de vidéosurveillance, données clients – réduit l’exposition au transport et au stockage cloud. C’est un argument de conformité, mais aussi de résilience opérationnelle : l’entreprise garde une partie de son intelligence décisionnelle sur site, même en cas de coupure réseau.
GPU, TPU, NPU, MCU : qui fait quoi ?
- CPU – Orchestration, logique métier, bases de données
Toutes les applications, mais peu adapté au calcul massivement parallèle de l’IA - GPU – Entraînement, inférence à forte densité, vision, LLM
Data center, cloud, IA générative, mais coût, consommation, et tension sur l’approvisionnement - TPU / ASIC IA – Calcul tensoriel spécialisé
Grands volumes d’inférence, plateformes cloud, mais forte dépendance à un écosystème et à un fournisseur - NPU – Inférence locale efficace
PC, mobiles, caméras, IoT, industrie, mais puissance limitée pour les très grands modèles - MCU / MPU – Contrôle, capteurs, systèmes embarqués
Robotique, automatisation, edge industriel, mais capacité IA limitée sans accélérateur dédié - FPGA – Traitement reconfigurable, protocoles spécifiques
Télécoms, finance, défense, industrie, mais coût, complexité de développement, compétences rares
Le GPU demeure la référence pour l’entraînement du deep learning, tandis que les TPU sont des circuits spécifiquement optimisés pour les opérations tensorielles utilisées par les cadres d’apprentissage automatique. À l’inverse, les NPU ne visent pas à remplacer un cluster d’entraînement : ils rendent économiquement viable l’IA embarquée et l’inférence de proximité.
Le PC IA : première vague d’adoption massive
L’entreprise va d’abord rencontrer ces processeurs là où elle ne les attendait pas forcément : sur le poste de travail. Les PC dits « IA » intègrent un NPU à côté du CPU et du GPU afin d’exécuter certaines fonctions localement – transcription, résumé, assistance, recherche, sécurité comportementale, vision.
Gartner anticipe que la totalité des nouveaux PC professionnels seront équipés de puces IA d’ici la fin 2026. Cette bascule ne signifie pas que chaque salarié entraînera des modèles sur son ordinateur portable. Elle signifie surtout que l’inférence légère deviendra une capacité standard du parc informatique, au même titre que le Wi-Fi ou le chiffrement matériel.
Pour les RSSI et les DSI, l’enjeu sera de distinguer les usages réellement utiles du marketing autour du « PC IA ». Un NPU ne transforme pas un ordinateur en ferme d’entraînement ; il peut en revanche décharger le CPU et le GPU, améliorer l’autonomie et permettre des fonctions sensibles sans envoyer les données vers un service externe.
L’edge industriel, terrain le plus concret
C’est probablement dans l’industrie, la logistique, la santé, la distribution et les infrastructures que ces processeurs auront l’impact le plus immédiat. Une usine n’a pas besoin d’un LLM géant pour inspecter une pièce, détecter une anomalie thermique ou piloter un bras robotisé. Elle a besoin d’une inférence fiable, déterministe, peu énergivore et intégrée à des systèmes de contrôle temps réel.
Les architectures distribuées deviennent alors la norme : des MCU pour les capteurs et le contrôle moteur, des MPU pour la logique applicative, des NPU pour l’inférence, et éventuellement un GPU ou un serveur local pour les modèles plus lourds. Cette répartition limite la latence, isole les fonctions critiques et réduit la dépendance à une connexion permanente.
Le FPGA conserve ici une place spécifique. Reconfigurable après fabrication, il permet d’adapter le traitement à des protocoles, des formats de capteurs ou des algorithmes évolutifs, un atout dans les environnements à cycle de vie long, mais au prix d’une complexité de développement élevée.
Les limites d’un futur trop spécialisé
La spécialisation a un revers. Multiplier les types de puces, c’est aussi multiplier les chaînes d’outils, les compilateurs, les formats de modèles, les compétences et les dépendances fournisseurs. Une entreprise qui choisit un accélérateur propriétaire peut gagner en performance immédiate, mais se retrouver enfermée dans une pile logicielle peu portable.
Le risque est donc moins technique qu’organisationnel : construire des îlots d’IA non interopérables, difficiles à superviser, à sécuriser et à renouveler. Les analyses du secteur insistent d’ailleurs sur l’absence d’architecture universellement supérieure : le choix doit dépendre des contraintes applicatives, du cycle de vie, de la sécurité et des exigences réglementaires.
Il faut aussi distinguer l’inférence de l’entraînement. Les TPU, GPU et autres accélérateurs massifs resteront concentrés chez les grands fournisseurs de cloud et les entreprises disposant de moyens considérables. Pour la majorité des organisations, la valeur ne viendra pas de l’entraînement d’un modèle de fondation, mais de l’exécution efficace de modèles adaptés à leurs données et à leurs processus.
Ce que les entreprises doivent décider maintenant
La bonne stratégie n’est pas de choisir « le meilleur processeur », mais de cartographier les charges de travail. Une approche pragmatique consiste à classer les usages selon quatre critères : criticité temps réel, sensibilité des données, volume d’inférence, et durée de vie du système.
- IA générative et entraînement : GPU, cloud ou infrastructure dédiée, avec une attention forte au coût énergétique et à la souveraineté.
- Agents, RAG et inférence d’entreprise : GPU ou accélérateurs spécialisés en data center, avec arbitrage entre performance, coût par requête et contrôle des données.
- Poste de travail : NPU intégré, pour les fonctions d’assistance locales et la réduction des échanges cloud.
- Industrie, mobilité, IoT : MCU, MPU et NPU distribués, avec FPGA lorsque la flexibilité matérielle est déterminante.
Les recommandations du marché convergent vers une cartographie des workloads sur 18 à 24 mois avant tout investissement lourd en accélération IA. C’est une discipline saine : la performance brute ne sert à rien si le modèle n’est pas déployable, supervisable et soutenable énergétiquement.
Un avenir hybride, pas un remplacement
Les nouveaux processeurs ne remplaceront ni le GPU ni le cloud. Ils vont surtout faire éclater l’IA en couches : des modèles géants entraînés dans des data centers hyperscalers, des modèles d’entreprise exécutés sur des infrastructures dédiées, et une inférence de proximité intégrée aux terminaux et aux machines.
C’est cette hiérarchie qui constituera l’avenir de l’IA en entreprise. Les TPU et GPU resteront les moteurs de la puissance brute ; les NPU, MCU et MPU deviendront les organes sensoriels et décisionnels du système d’information. La vraie rupture ne sera donc pas la puce elle-même, mais la capacité des entreprises à orchestrer un calcul devenu hétérogène, sans sacrifier ni le coût, ni l’énergie, ni le contrôle de leurs données.