Avec Azure Maia 300, Microsoft ne se contente pas de lancer une troisième génération d’accélérateur maison, il annonce vouloir en faire, dès 2027, le principal système d’inférence de ses produits et services, à une échelle « multi-gigawatt ». Derrière la promesse d’efficacité énergétique se dessine un basculement stratégique majeur, moins dépendant de Nvidia et plus verticalisé.
Maia 300 est explicitement présentée comme une architecture « inference-first », optimisée pour le décodage, les contextes longs, le raisonnement, les conversations sensibles à la latence et les agents multi-étapes. Microsoft vise moins l’entraînement des grands modèles que la phase économiquement la plus volumique du cycle IA : servir des milliards de requêtes Copilot, GitHub, Foundry, Teams ou Dragon Copilot.
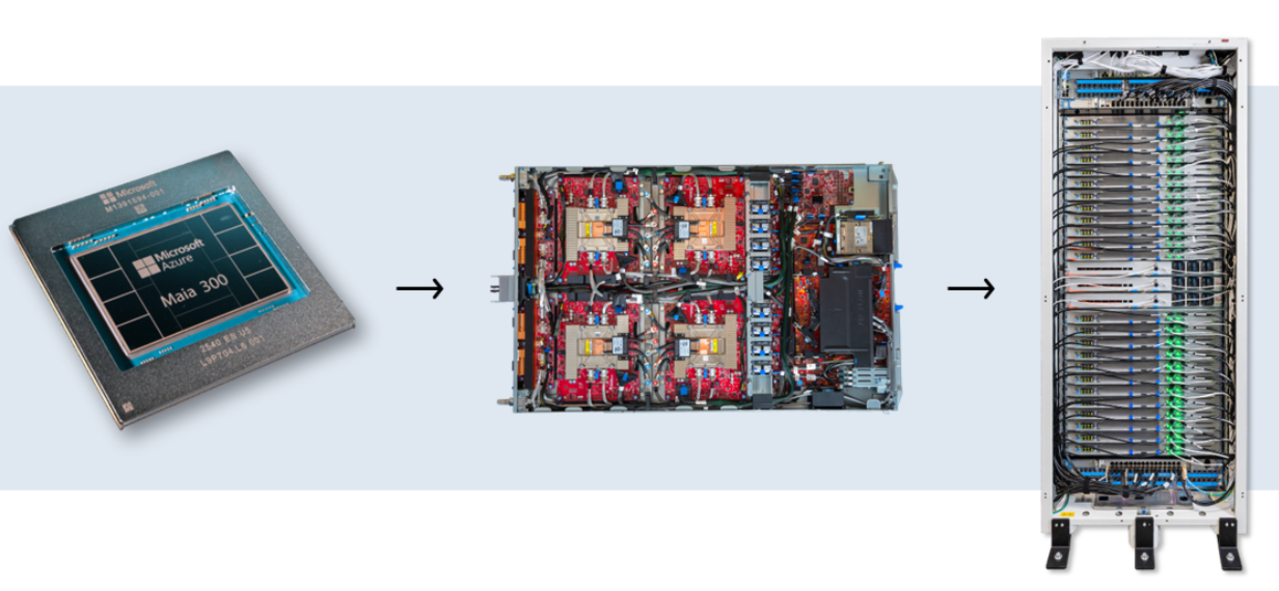
Chaque accélérateur embarque huit piles HBM4, soit 288 Go de mémoire, et une bande passante crête de 18 To/s, dans une enveloppe thermique de 950 W. À l’échelle d’une baie, 96 accélérateurs sont regroupés dans une enveloppe de 167 kW, avec 27,6 To de HBM et 1,7 Po/s de bande passante agrégée. La densité double par rapport à Maia 200, tandis que le domaine scale-up peut réunir jusqu’à 12 288 accélérateurs en superpod via une architecture Ethernet à deux niveaux.
Le chiffre le plus politique de l’annonce est celui des 40 % de tokens supplémentaires par mégawatt revendiqués face à des systèmes GPU « leaders ». Microsoft promet aussi jusqu’à sept fois le débit de tokens par baie de Maia 300 par rapport à Maia 200, et plus de 2,5 fois la performance par watt. La comparaison avec les GPU reste toutefois à manier avec prudence.
Le vrai enjeu : le mégawatt, pas le flops
L’annonce doit être lue comme un arbitrage énergétique. À 167 kW par baie, Maia 300 entre dans une catégorie où le refroidissement liquide cesse d’être une option. Microsoft indique que plus de 80 % de la charge thermique est évacuée par liquide, le reste l’étant par air. L’alimentation repose sur un busbar 50 V au niveau du rack.
Cette densité réduit le nombre de baies pour un même service, mais concentre mécaniquement les contraintes : distribution électrique, redondance, maintenance à chaud, qualité de l’eau, débit et température des boucles de refroidissement, ainsi que capacité de rejet thermique. Le passage au multi-gigawatt signifie que chaque point de pourcentage d’efficacité se traduit en dizaines, voire centaines de mégawatts économisés… ou consommés.
Microsoft présente cette intégration comme un système co-conçu : silicium, logiciel, réseau, rack et data center. C’est précisément là que réside sa force industrielle, mais aussi son risque : une plateforme aussi verticale est difficile à comparer, à auditer et à réutiliser pour des charges hétérogènes.
Une stratégie anti-dépendance, pas un « Nvidia killer »
Microsoft adresse un message à Nvidia et AMD : l’éditeur veut internaliser une part croissante de son inférence. La logique est double : maîtriser le coût unitaire du token et sécuriser l’approvisionnement dans un marché où HBM, GPU et capacité de montage restent tendus. Plusieurs analyses soulignent que l’enjeu est moins de remplacer Nvidia que de déplacer une partie de la consommation interne vers du silicium propriétaire.
Mais la bascule ne sera ni immédiate ni totale. Maia 300 n’entrera en production qu’en 2027, et Microsoft continuera vraisemblablement de s’appuyer sur des GPU pour l’entraînement, les modèles tiers, les pics de demande et les clients Azure exigeant des écosystèmes CUDA. Maia devient le moteur privilégié de l’inférence interne, non une alternative universelle.
Maia 300 marque donc le passage à une infrastructure d’inférence de production. Microsoft cherche à transformer l’efficacité énergétique en avantage concurrentiel : plus de tokens servis par mégawatt, plus de densité par baie, moins de dépendance aux fournisseurs de GPU. Mais Microsoft saura-t-il déployer ces baies de 167 kW à l’échelle annoncée sans buter sur les réseaux électriques et thermiques ?