L’expression russe « ЦОД судного дня », littéralement « centre de traitement des données du jugement dernier », désigne une infrastructure informatique destinée à assurer la continuité des services numériques dans les situations extrêmes.
Rostelecom, l’un des principaux opérateurs russes de télécommunications et de services numériques, a lancé une proposition qui illustre un changement majeur dans la conception de la sécurité numérique en Russie : créer un data center dit « du jugement dernier », conçu pour permettre la restauration rapide des services numériques après une catastrophe, une cyberattaque ou la destruction d’infrastructures informatiques.
Le terme « jugement dernier » ne signifie pas que le projet serait lié à une installation militaire secrète, à un bunker nucléaire ou à un système destiné à survivre à la fin du monde. Il s’agit d’une formule imagée employée par Valeri Ermakov, vice-président du conseil d’administration de Rostelecom, pour souligner la nécessité de disposer d’un dispositif de secours capable de fonctionner lorsque les infrastructures informatiques habituelles sont gravement perturbées.
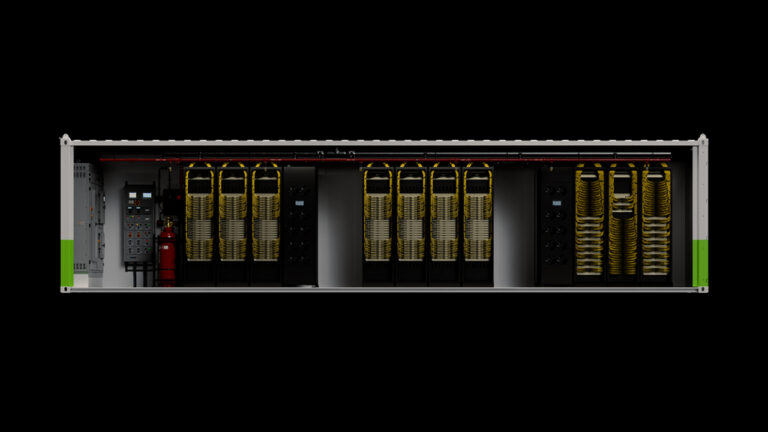
Data center du jugement dernier
Derrière cette appellation spectaculaire se cache un concept technique bien connu des spécialistes de l’informatique : un centre de secours numérique, doté de sauvegardes et de capacités de reprise après sinistre. Sa particularité serait de répondre à un contexte dans lequel les centres de données ne sont plus seulement exposés aux pannes électriques, aux erreurs humaines ou aux cyberattaques, mais également aux menaces physiques visant directement les installations.
La proposition intervient après plusieurs incidents ayant affecté des centres de données russes en octobre 2026, notamment des attaques signalées contre des infrastructures de Yandex et une attaque rapportée contre un centre de données de Sberbank. Ces événements ont remis au premier plan une question essentielle : comment maintenir le fonctionnement des services numériques lorsque les infrastructures qui les hébergent deviennent elles-mêmes des cibles ?
L’enjeu dépasse largement le secteur informatique. Il concerne les banques, les télécommunications, les administrations, le commerce électronique, les services de transport et, plus généralement, la continuité de la vie économique.
Comprendre la proposition de Rostelcom
Le projet évoqué par Rostelecom s’inscrit dans cette logique de résilience numérique, et son responsable insiste sur une fonction essentielle : disposer d’une plateforme de sauvegarde à partir de laquelle les services peuvent être restaurés rapidement.
Pour comprendre cette proposition, il faut distinguer trois éléments.
- Le data center principal : il héberge les applications, les bases de données et les ressources informatiques utilisées quotidiennement.
- Le centre de secours : il dispose de ressources capables de reprendre tout ou partie des activités lorsque le site principal devient indisponible.
- Le système de sauvegarde : il conserve des copies des données et, idéalement, des configurations nécessaires pour reconstruire les systèmes informatiques.
Un véritable dispositif de reprise après sinistre combine ces trois fonctions. Une simple copie des données ne suffit pas nécessairement : il faut aussi pouvoir redémarrer les applications, rétablir les connexions réseau, vérifier l’intégrité des informations et rétablir les accès des utilisateurs.
De la centralisation à l’architecture distribuée
Le modèle traditionnel repose souvent sur de grands data centers centralisés, conçus pour fournir des capacités importantes à un coût compétitif. Le modèle distribué répartit les applications et les données sur plusieurs installations. Cette organisation peut limiter les conséquences d’un incident localisé, à condition que les différents sites disposent de ressources suffisantes et puissent communiquer entre eux.
Dans son intervention, Valeri Ermakov évoque une architecture en « microcellules », c’est-à-dire une organisation dans laquelle les services sont répartis entre un plus grand nombre de sites et bénéficient de capacités de secours.
Il ne s’agit pas nécessairement de construire un unique centre gigantesque et indestructible. Une interprétation techniquement cohérente de sa proposition est au contraire de renforcer un ensemble de sites interconnectés, avec des fonctions de sauvegarde et de restauration adaptées à chaque service.
Le véritable obstacle : les réseaux de télécommunication
Un data center de secours ne peut pas fonctionner efficacement sans réseau. Les entreprises doivent pouvoir transférer leurs sauvegardes, synchroniser leurs bases de données, transmettre les demandes des utilisateurs et rediriger les flux informatiques lorsque le site principal est indisponible. Or, selon Valeri Ermakov, deux difficultés compliquent le développement d’une architecture distribuée en Russie : la saturation de certaines capacités des réseaux dorsaux et le vieillissement d’une partie des infrastructures optiques existantes.
Les réseaux dorsaux, ou backbones, transportent de grandes quantités de données entre les régions, les data centers et les principaux points d’interconnexion. La multiplication des sites informatiques augmente potentiellement les besoins de transport. Les sauvegardes, la réplication des données et les communications entre applications peuvent représenter des volumes importants.
Si la capacité du réseau est insuffisante, les opérations de réplication risquent de prendre du retard. En situation de crise, cette limitation peut ralentir la restauration des services. La difficulté est particulièrement importante pour les applications qui nécessitent des données récentes ou des échanges fréquents entre plusieurs sites.
Un data center de secours peut-il vraiment tout sauver ?
Malgré son utilité, un data center de secours ne garantit pas une continuité absolue. Une sauvegarde peut contenir des données corrompues ou des logiciels compromis. Si l’organisation restaure un système infecté sans vérifier son intégrité, elle risque de reproduire l’incident sur son infrastructure de secours. La protection doit donc intégrer des contrôles de sécurité, des historiques de sauvegarde et des procédures de reconstruction fiables.
Si les comptes d’administration, les outils d’orchestration ou les mécanismes d’authentification sont compromis, l’attaquant peut parfois perturber à la fois la production et les dispositifs de secours. L’isolation des environnements, la séparation des privilèges et la protection des accès sont donc essentielles.
Une infrastructure de secours peut être conçue pour prendre en charge uniquement les fonctions prioritaires. Si toutes les applications doivent être rétablies simultanément, ses ressources peuvent se révéler insuffisantes. Il faut alors déterminer quels services seront rétablis en premier, quels niveaux de performance seront maintenus et combien de temps les utilisateurs devront attendre pour retrouver toutes les fonctionnalités.
Enfin une crise régionale, une défaillance importante du réseau électrique ou une interruption de télécommunication peut affecter plusieurs centres à la fois. Le système de secours doit donc être conçu en tenant compte de scénarios où plusieurs dépendances disparaissent simultanément. Et même une infrastructure informatique parfaitement restaurée ne peut pas remplacer les systèmes physiques qui dépendent d’elle : équipements de paiement, réseaux de distribution, dispositifs industriels ou terminaux des utilisateurs. La continuité numérique reste liée à celle des infrastructures matérielles.